Строю SOC для своих SaaS проектов
ENWazuh, ClickHouse, и AI-агенты вместо команды безопасности

Denis Zuikov
· 12 мин чтения
В последние годы я, как и многие, строю собственные небольшие SaaS проекты. И, казалось бы, если проект небольшой, то и инфраструктура у него несложная. Но даже если вы держите фронт на Vercel, а базу в Supabase, у вас всё равно есть сами Vercel и Supabase, а ещё GitHub, Stripe, админка DNS, почта, сервис рассылки писем пользователям, API какой-нибудь LLM и т. д. И у каждого сервиса — своя админка, свои токены и свои журналы.
А для своего последнего проекта я решил держать бэкенд на VPS в облаке Contabo, и за 8 месяцев разработки набралось три сервера и ещё с десяток сервисов вокруг них.
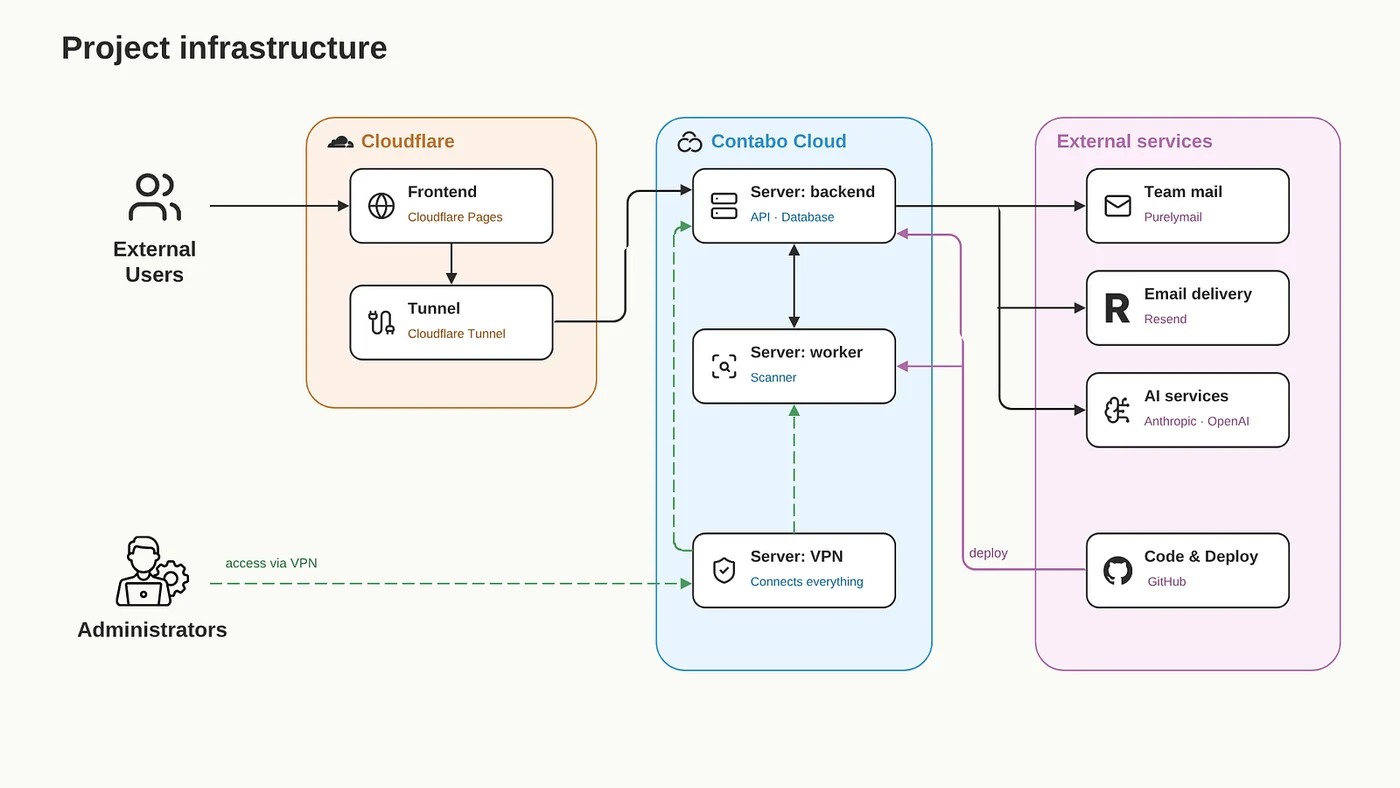
Конечно же для каждого проекта я всегда делаю базовый харденинг безопасности, настраиваю мониторинг доступности, двухфакторную аутентификацию и внимательно отношусь к правам доступа. Но с моим бэкграундом безопасника мне всегда хотелось видеть и контролировать больше, а желательно вообще всё, что происходит в инфраструктуре. Я хочу знать, не получил ли кто-то доступ к моему серверу, не угнал ли кто-то токен от LLM, не брутфорсит ли кто-то БД, которую я случайно сделал доступной из интернета.
Работая в большой компании, я привык, что всегда есть Security Operations Center (SOC), где сидят 10+ человек, собирают логи со всех узлов, анализируют их и реагируют на угрозы 24/7. И даже если ты допустил какую-то ошибку в безопасности, заметят либо её, либо то, что кто-то её эксплуатирует. И наличие этого самого SOC реально создаёт ощущение безопасности и контроля. В моих собственных проектах мне этого не хватает: никто не мониторит всё… ну, кроме меня, и то с сомнительным качеством.
И, кажется, сейчас то самое время, когда один человек вполне может эту проблему решить, делегировав ИИ всю самую грязную работу, и сосредоточившись на основных функциях безопасности и архитектуре. Я решил попробовать, ведь на собственном маленьком проекте можно легко экспериментировать, давать больше прав для реагирования, смелее применять ИИ и давать ему больше свободы, чем это допустимо в большой инфраструктуре.
Когда я это задумывал, в голове было следующее:
- SOC должен жить на одном сервере;
- я должен получать мало алертов — только о действительно важных вещах;
- система должна сама учиться на моих ответах;
- мониторингом должны быть охвачены абсолютно все компоненты инфраструктуры;
- должно быть единое место, где я могу задать любой вопрос о происходящем в проекте: кто создал новый сервер, кто и зачем выпустил новый ключ доступа к репозиторию, на что ушли токены и т. д.;
- SOC должен как минимум детектировать инциденты ИБ, а в идеале реагировать самостоятельно;
Итак, задача поставлена, начинаем строить.
СТРОИТЕЛЬСТВО
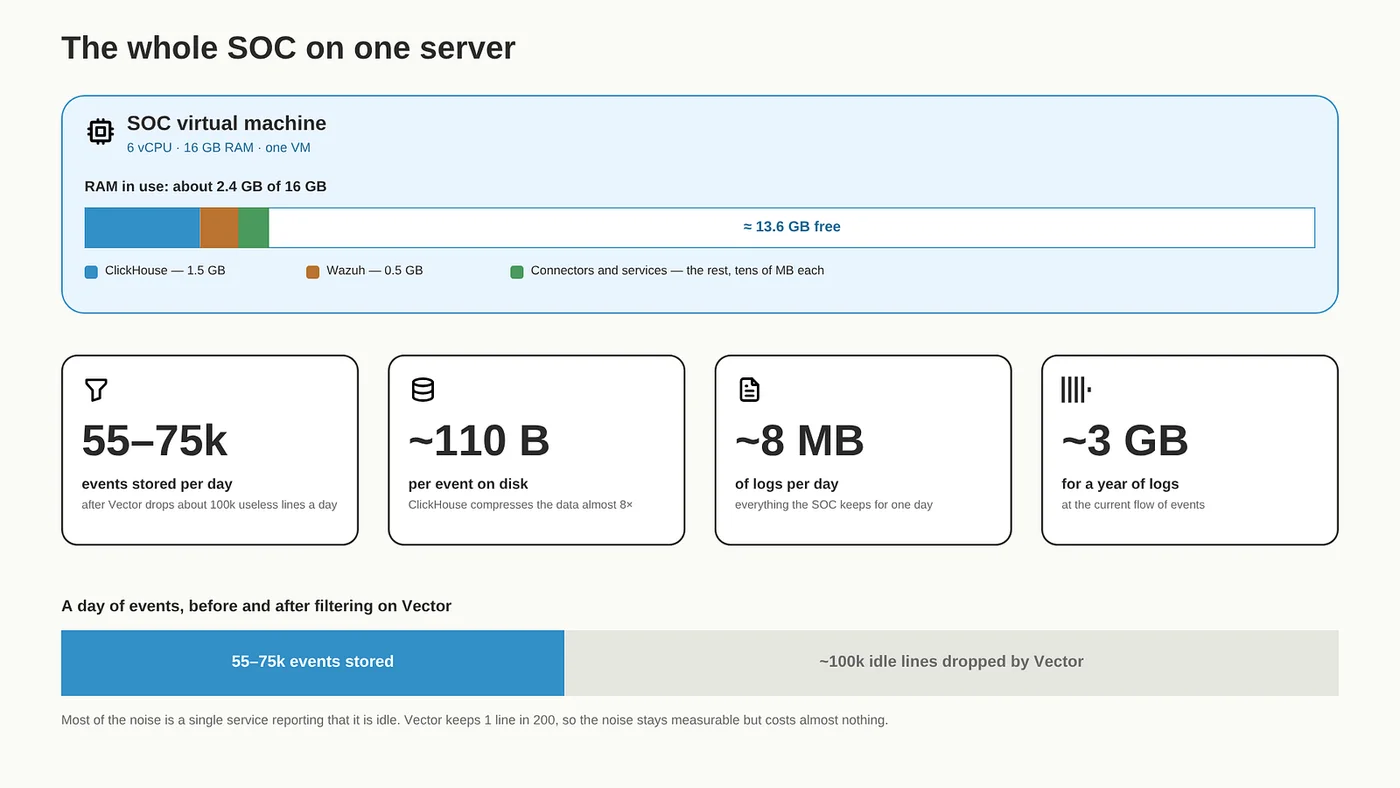
Для начала расскажу, какую архитектуру я выбрал и на базе чего я буду строить. Как я уже говорил, я хотел чтобы всё помещалось на один сервер, поэтому для SOC я выделил отдельную виртуалку с 6 vCPU и 16 ГБ RAM.
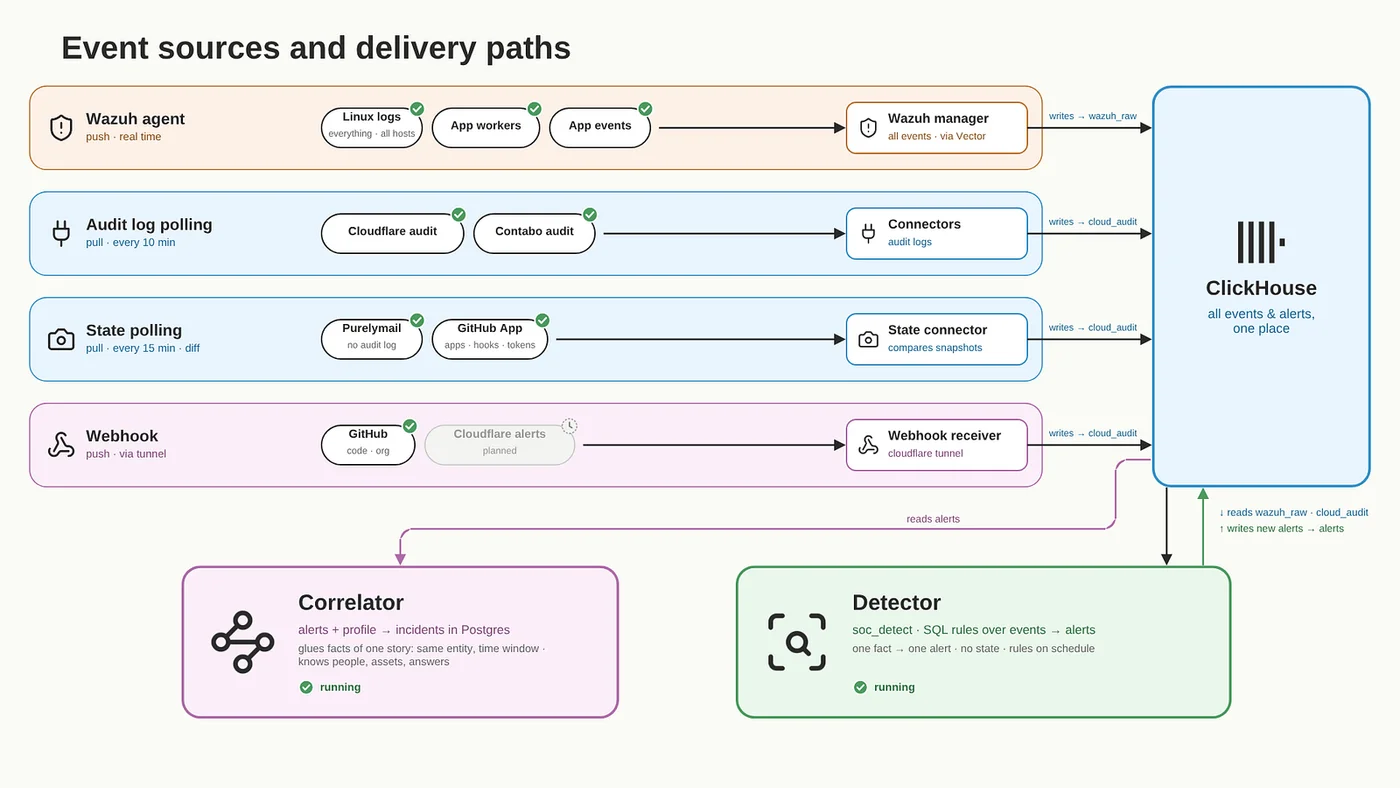
Сбор событий с серверов я построил на базе Wazuh: он уже отлично умеет собирать логи, генерить алерты, имеет базу готовых правил и позволяет дописывать свои собственные, поэтому не придётся ничего вайбкодить в этой части. А вот индексатор Wazuh на OpenSearch, который идёт с ним в комплекте, я использовать не стал: для одного сервера это слишком тяжело и достаточно медленно, там Java. Поэтому Wazuh пока остался только тем, что собирает события и генерирует алерты.
А вот для хранения событий и алертов я выбрал ClickHouse. Он позволит компактно хранить события и быстро выполнять запросы для сложных расследований.
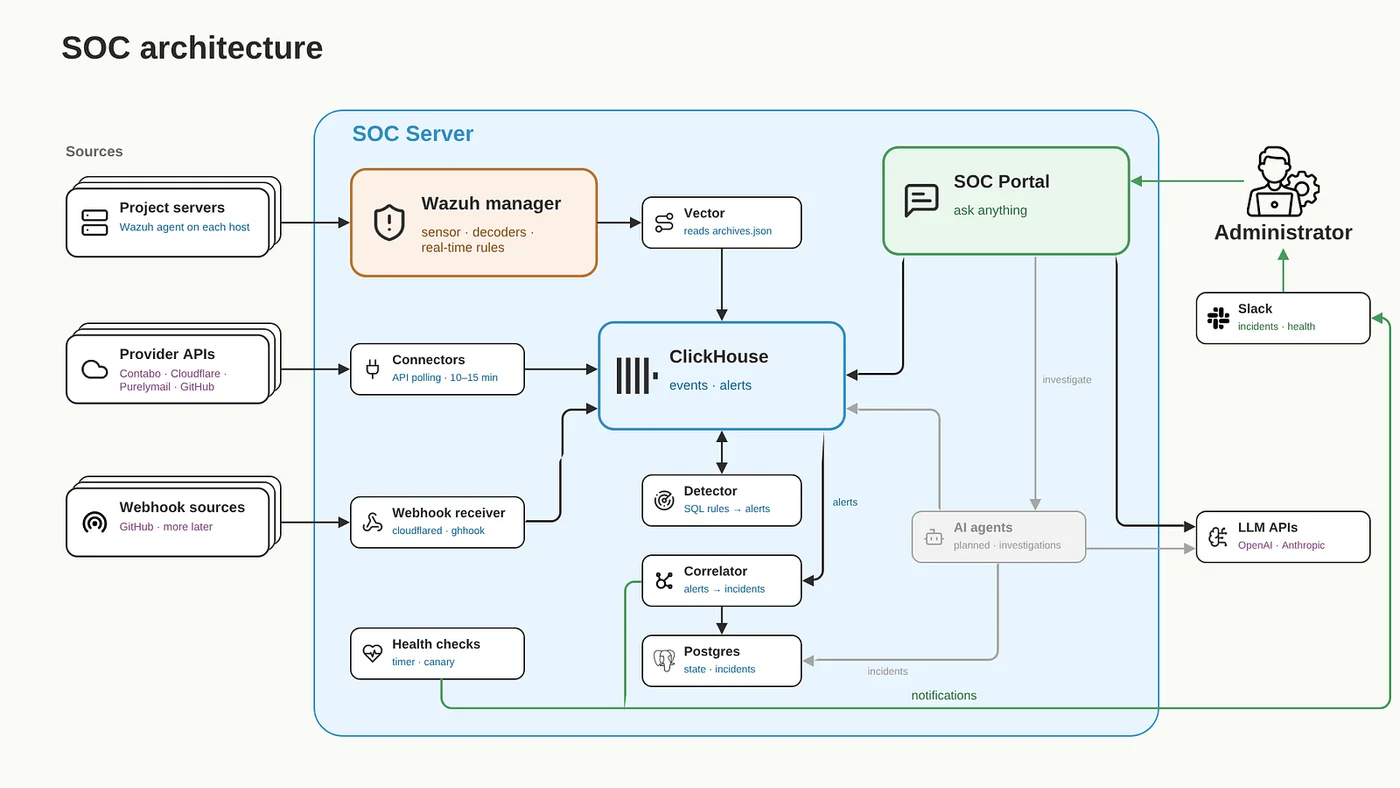
Я соединил ClickHouse и Wazuh через файл archives.json. В этот файл Wazuh записывает все события и алерты. Далее этот файл читает Vector, и события попадают в ClickHouse. При такой схеме мы получаем основные преимущества и наработки Wazuh, но не используем медленную базу OpenSearch, имея возможность делать быстрые и эффективные запросы на базе ClickHouse.
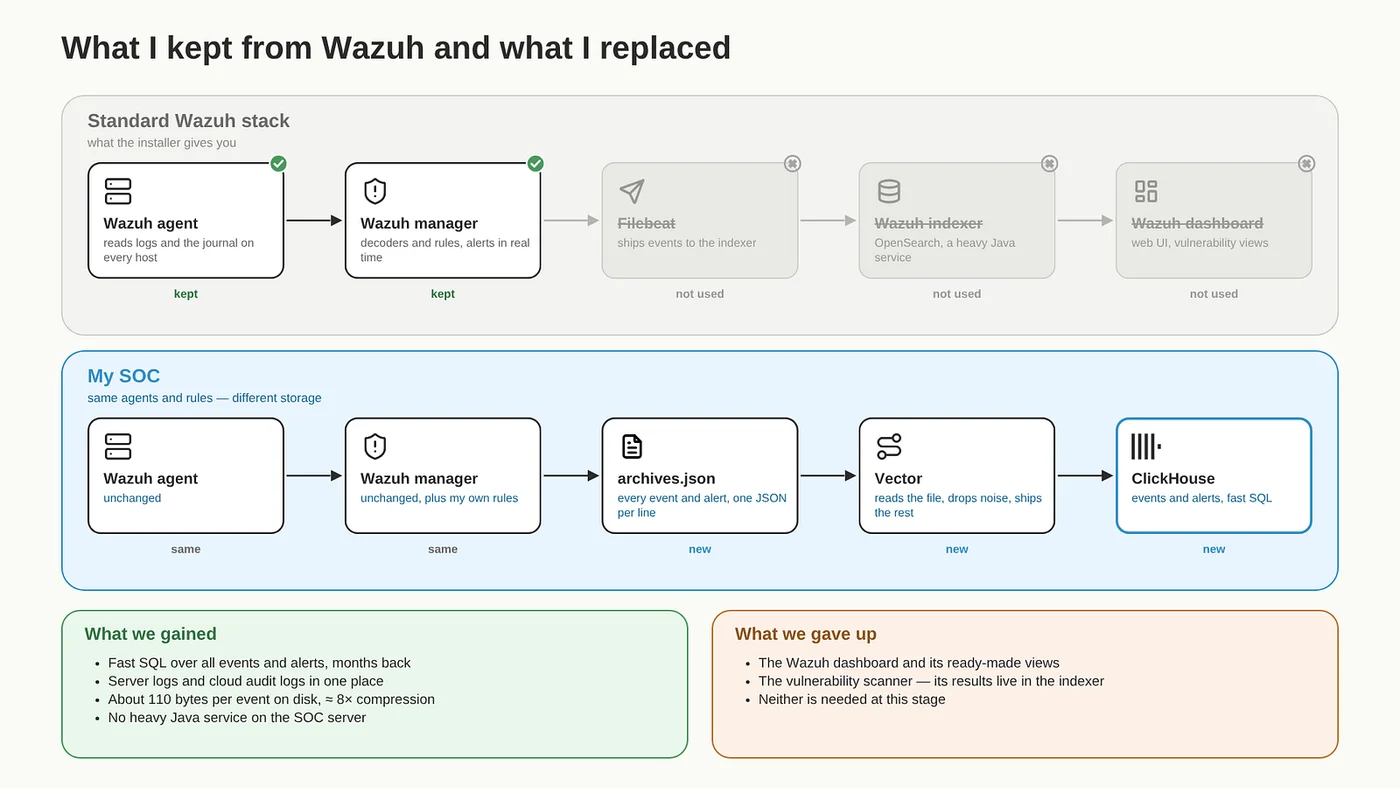
Правда, при этом мы теряем некоторый функционал Wazuh, например сканер уязвимостей и дашборд, но на данном этапе он нам не нужен.
Для некоторых облачных сервисов нет возможности собирать логи с помощью Wazuh, так как их нужно либо опрашивать по API, либо получать информацию с помощью вебхуков, а готовых модулей для таких сервисов у Wazuh нет. Поэтому для них пришлось разработать коннекторы, которые работают по расписанию и сами ходят забирать информацию из источников: маленькие, самописные, на каждый — отдельный контейнер и пара сотен строк на Python. Большинство из них сами раз в 10–15 минут ходят в API и пишут в ClickHouse. Открытых наружу портов у SOC нет: агенты шлют события внутри VPN, а коннекторы сами ходят за данными. Сложнее с GitHub: на бесплатном тарифе он умеет только присылать события вебхуками. Поэтому приёмник спрятан за туннелем Cloudflare: SOC сам устанавливает исходящее соединение до Cloudflare, и запросы GitHub приходят по нему.
Эти события попадают в ClickHouse в обход Wazuh, поэтому не получилось иметь единое место для генерации алертов в виде Wazuh, а пришлось написать отдельный детектор, который периодически выполняет запросы в ClickHouse по правилам детектирования и записывает обратно в ClickHouse в таблицу для алертов. Ни один из open-source проектов не подошёл под мои критерии, и пришлось написать своё. Наиболее близким был ClickDetect. Возможно, я позже вернусь к нему.
И поверх всего этого работает коррелятор. Он смотрит на поступающие алерты и решает: завести новый инцидент, добавить алерт к уже открытому или не заводить инцидент вовсе. Коррелятор определяет срочность, при необходимости опрашивает администраторов в Slack и ведёт историю каждого инцидента. В следующих статьях расскажу про свои эксперименты в разработке AI-агентов для расследования инцидентов (сбора дополнительных логов, выполнение команд, реагирование и т. д.)
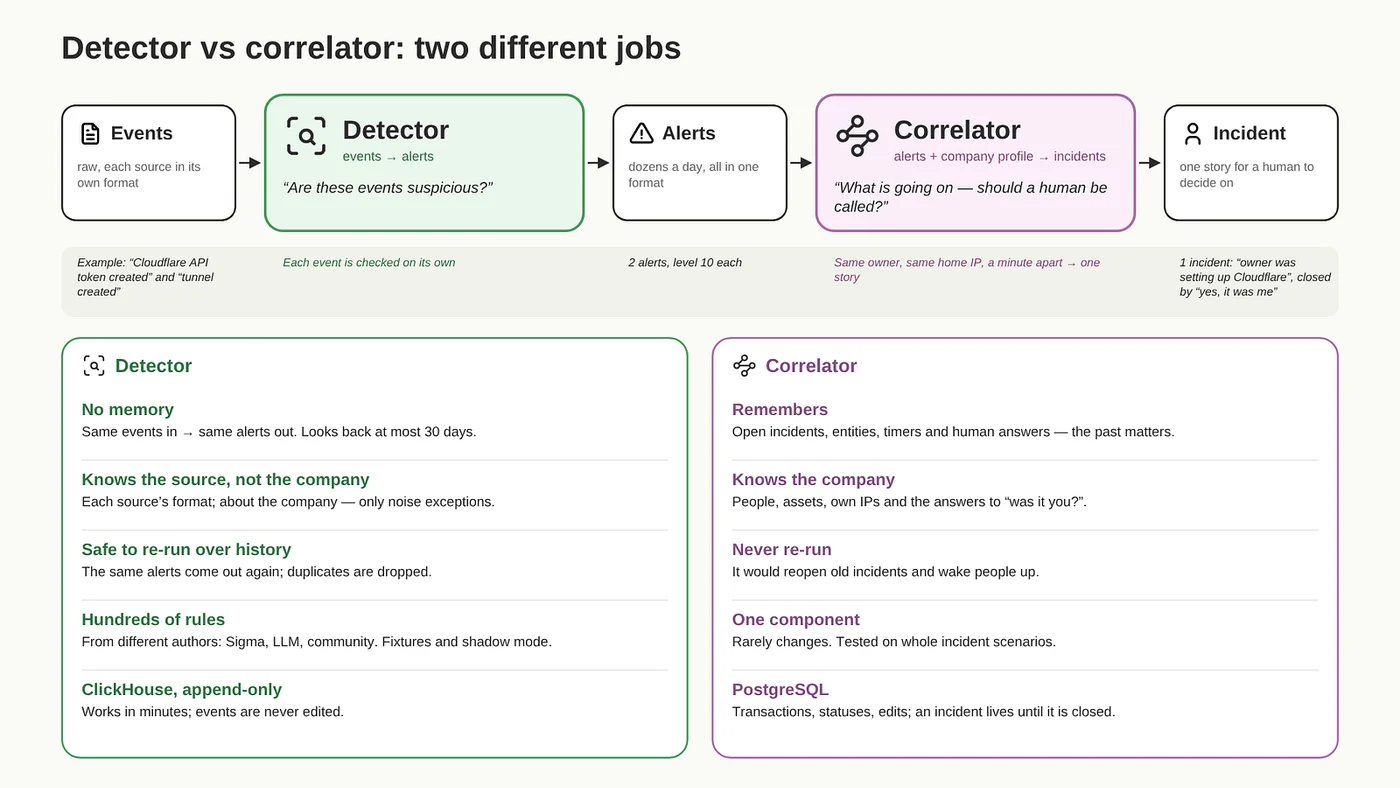
Всё, что касается инцидентов, хранится в PostgreSQL. Сами инциденты с их статусами (открыт, взят в работу, локализован, закрыт), какие алерты в них вошли, участники — IP-адреса, пользователи, ключи, хосты, хронология каждого инцидента, вопросы людям вместе с ответами и действия по реагированию — всё это данные, которые постоянно меняются, поэтому это задача как раз для реляционной базы. События и алерты при этом остаются в ClickHouse. Когда инцидент закрыт, он превращается в Markdown-отчёт и ложится в git-репозиторий.
В дополнение ко всему этому есть SOC-портал, где можно в свободной форме задать любой вопрос по происходящему в инфраструктуре. Ответ приходит в формате обычного текста вместе с данными, на которых он основан. В будущем отсюда же можно будет самому инициировать новое расследование.
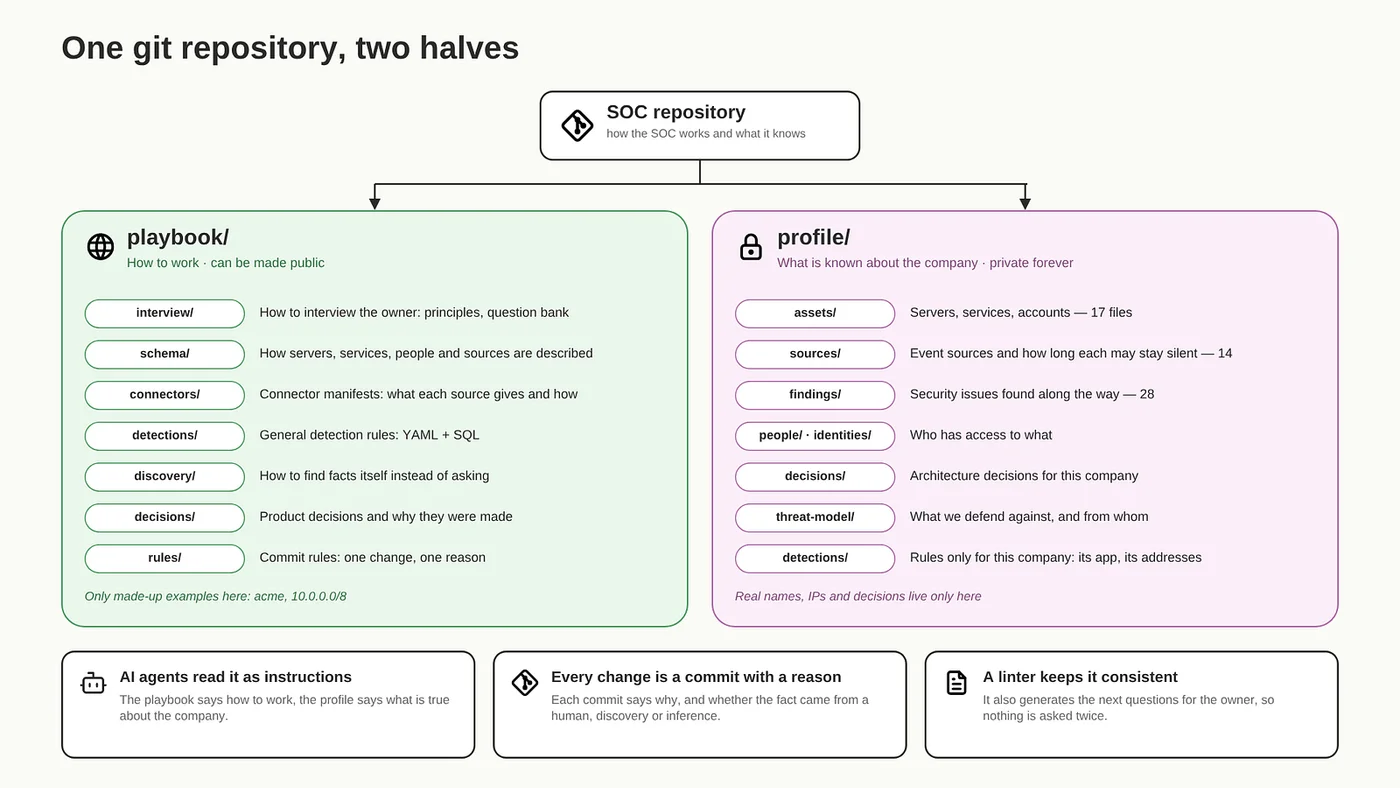
Так как я строю этот SOC с активной помощью ИИ, я решил записывать все принципы его работы, архитектурные решения и процессы в единый git-репозиторий. Таким образом, у меня получится полностью воспроизводимый SOC из git-репозитория, который в будущем можно будет использовать под другие проекты. Репозиторий делится на две части. Первая — «как работать»: принципы работы, схема описания инфраструктуры, общие правила детектирования, описания коннекторов; её в будущем можно будет открыть. Вторая — «что известно о компании»: серверы, сервисы, люди, принятые решения; она навсегда останется приватной. Также в этом репозитории удобно ввести реестр источников и обнаруженных проблем безопасности инфраструктуры, чтобы постепенно эти самые источники подключать и решать проблемы.
ПОДКЛЮЧЕНИЕ ИСТОЧНИКОВ
Далее я приступил к подключению источников событий. В этой части есть много нюансов: одни источники сами присылают логи, другие отдают журнал по API, а третьи не отдают ничего, кроме текущего состояния. Например, выяснилось, что у почтового провайдера Purelymail журнала нет вообще, а токен для API бывает только с полными правами, типа root. Я, конечно же, создал тикет с feature request на более гранулярные доступы. Будем ждать. Также оказалось, что GitHub без Enterprise-подписки, отдаёт данные тремя разными способами, и ни один не покрывает всё. Далее расскажу об основных нюансах всех источников, которые успел подключить на данный момент.
ЛОГИ СЕРВЕРОВ
Логи серверов отправляет агент Wazuh: он читает системный журнал, где есть входы по SSH, события Docker и всё, что пишут сервисы. Здесь всё было просто.
ЛОГИ ОСНОВНОГО ПРИЛОЖЕНИЯ
Только эти логи говорят, что реально происходит внутри самого продукта. Приложение пишет события безопасности в системный журнал, и оттуда их забирает тот же агент Wazuh — отдельной интеграции не понадобилось.
Пришлось поручить LLM изучить код и документацию проекта и найти пробелы в логировании. Их оказалось много. Например, просроченный токен сессии и поддельный в логах выглядели одинаково, хотя первое — обычное дело, а второе — признак атаки. Запрос на сброс пароля записывался без IP-адреса источника, а при входе по паролю вместо IP-адреса пользователя в логах стоял один общий IP-адрес Cloudflare. А успешное использование машинного токена API не записывалось вообще, так что, если бы токен утёк, его нелегитимное использование никто бы не заметил.
LLM описала, какие новые логи и поля в существующие нужно добавить, и выдала задачу агенту разработки основного приложения. По событиям приложения мы вместе спроектировали 31 детект: 28 — правила Wazuh, три — для отдельного детектора, потому что им нужна история, которую Wazuh не учитывает.
CONTABO CLOUD (хостинг где живут мои виртуалки)
Журнал аудита Contabo коннектор забирает по API раз в 10 минут. SOC видит, кто создал или перезагрузил сервер, поменял файрвол или добавил ключ, и даже канал — руками в панели или через API. По истории за 8 месяцев оказалось, что больше половины записей — действия самого провайдера.
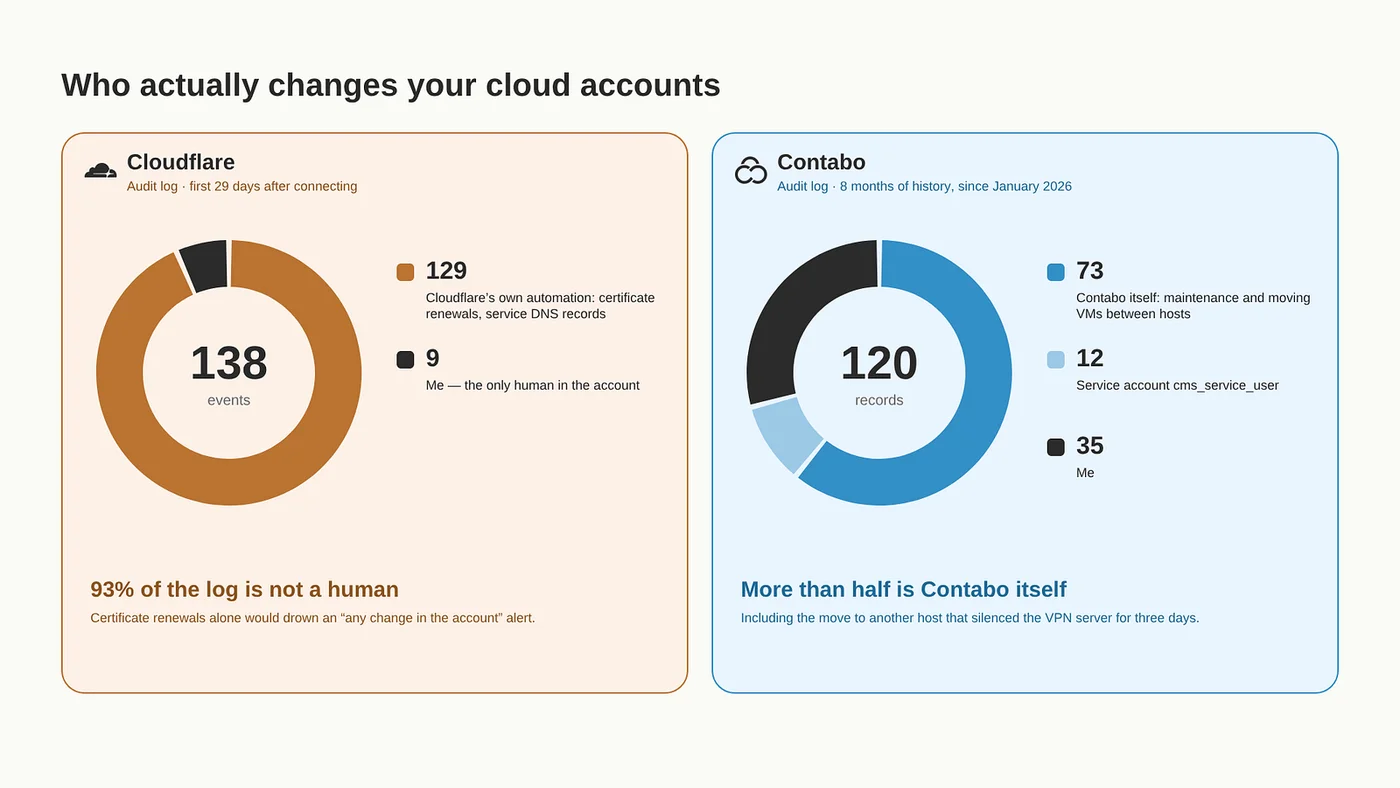
Журнал уже пригодился. Один из серверов внезапно замолчал, и именно журнал Contabo объяснил почему: провайдер перенёс сервер на другое физическое железо и перезагрузил его.
CLOUDFLARE
Для меня это критичный источник: весь внешний доступ к бэкенду идёт через туннель Cloudflare, и если кто-то получит доступ к админке, тот сможет туннель перенаправить. На данный момент я подключил только журнал аудита аккаунта. В нём видно и входы в аккаунт, и любые изменения — выпуск токена, правку туннеля или DNS, включая информацию о том кто это сделал и с какого IP-адреса.
За первый месяц истории пришло 138 событий, и 129 из них — автоматика самой Cloudflare: продление сертификатов и служебные DNS-записи. Моих действий всего девять.
Чего пока не видно: падения туннеля, DDoS и истечения сертификата. Это не действия человека, в журнале аудита их нет — они приходят только уведомлениями через вебхук, который я пока не настроил.
ПОЧТА Purelymail
Это самый необычный источник: журнала у этого почтового провайдера вообще нет, можно только получать текущее состояние по API. Поэтому коннектор раз в 15 минут снимает снимок настроек, сравнивает с прошлым и записывает только разницу. Токен можно создать только с полными правами. Надеюсь, в будущем Purelymail добавит гранулярную настройку прав для токенов и сделает журнал аудита.
Что видно при такой схеме: Будет обнаружен например, если добавлен новый адрес восстановления и новое правило пересылки — два классических способа тихо закрепиться в чужой почте. Плюс отключение второго фактора, поломка почтовых DNS-записей и закончившиеся на счёте деньги итд.
Чего, к сожалению, не видно: входов в ящики, кто сделал изменение и когда именно, и изменения, которое успели откатить между двумя снимками.
GITHUB
У личного аккаунта полноценного журнала аудита нет, поэтому сначала пришлось перенести репозитории в организацию, там журнал доступен. Но без Enterprise-подписки не получится автоматизировать выгрузку журнала, делать это можно только вручную из интерфейса.
Подписку на текущем этапе я покупать не хотел, поэтому пришлось придумать свой способ, совмещая разные методы получения информации из GitHub.
Необходимой видимости я добился через вебхуки и опрос API от имени GitHub App — служебной учётки организации со специальным набором разрешений только на чтение.
Вебхуки мгновенно показывают всё, что происходит с кодом и репозиториями (коммиты, смену видимости репозитория, новые deploy-ключи и т. д.), а GitHub App позволяет регулярно снимать состояние настроек и обнаруживать изменения: например, установку приложения в организацию, выключение обязательного второго фактора и т. д.
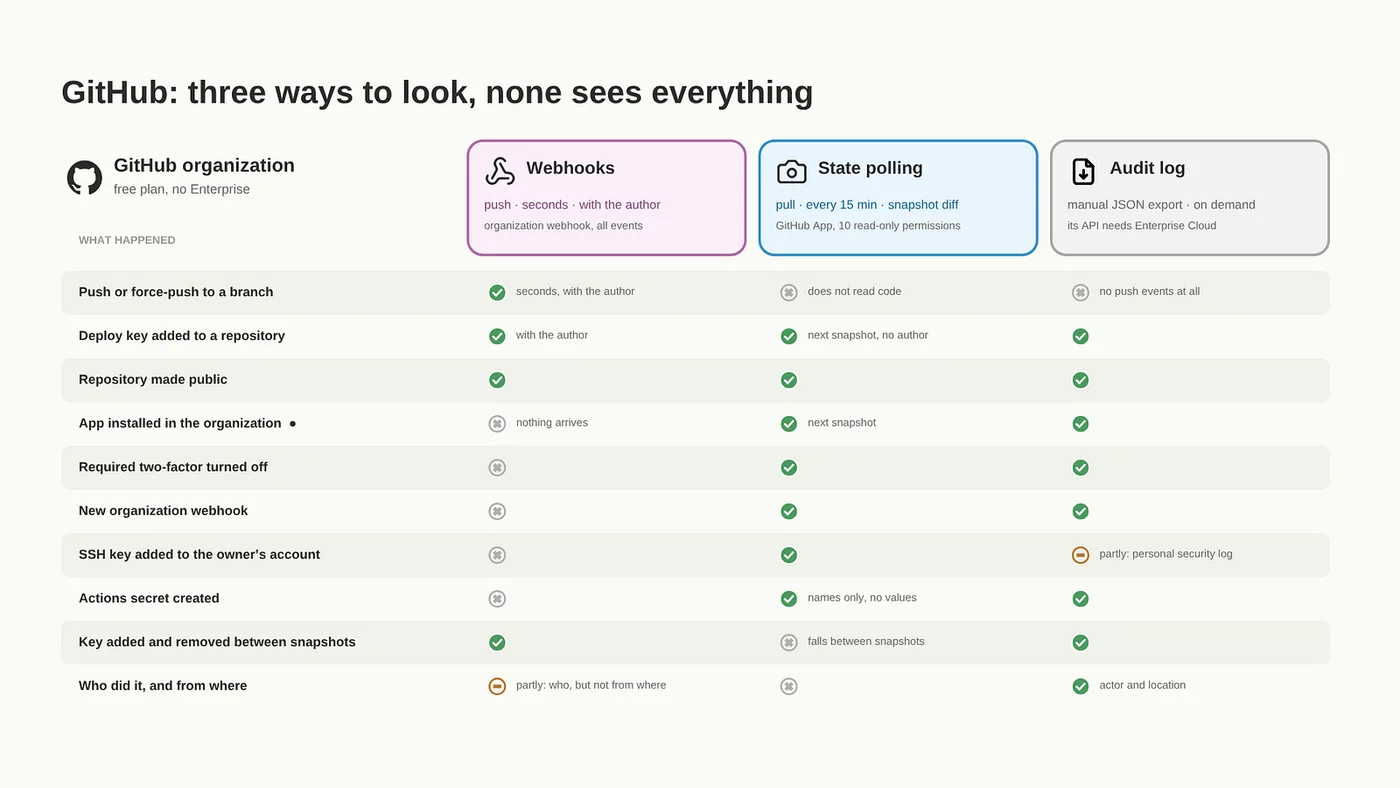
Но для более глубоких расследований иногда всё равно необходим журнал аудита — только в нём видно, кто и откуда менял настройки. Поэтому SOC может при необходимости запросить ручную выгрузку журнала: GitHub позволяет выгрузить его в формате JSON.
АДМИНИСТРИРОВАНИЕ ИСТОЧНИКОВ
Отдельная боль — это источники, которые тихо отваливаются. SOC, который перестал получать логи и не знает об этом, хуже, чем отсутствие SOC.
Я столкнулся с этим, когда агент Wazuh на одном из серверов не заработал корректно после перезагрузки: служба числилась запущенной, соединение с SOC было открыто, но данные не шли. Трое суток я не видел этот сервер и не знал об этом.
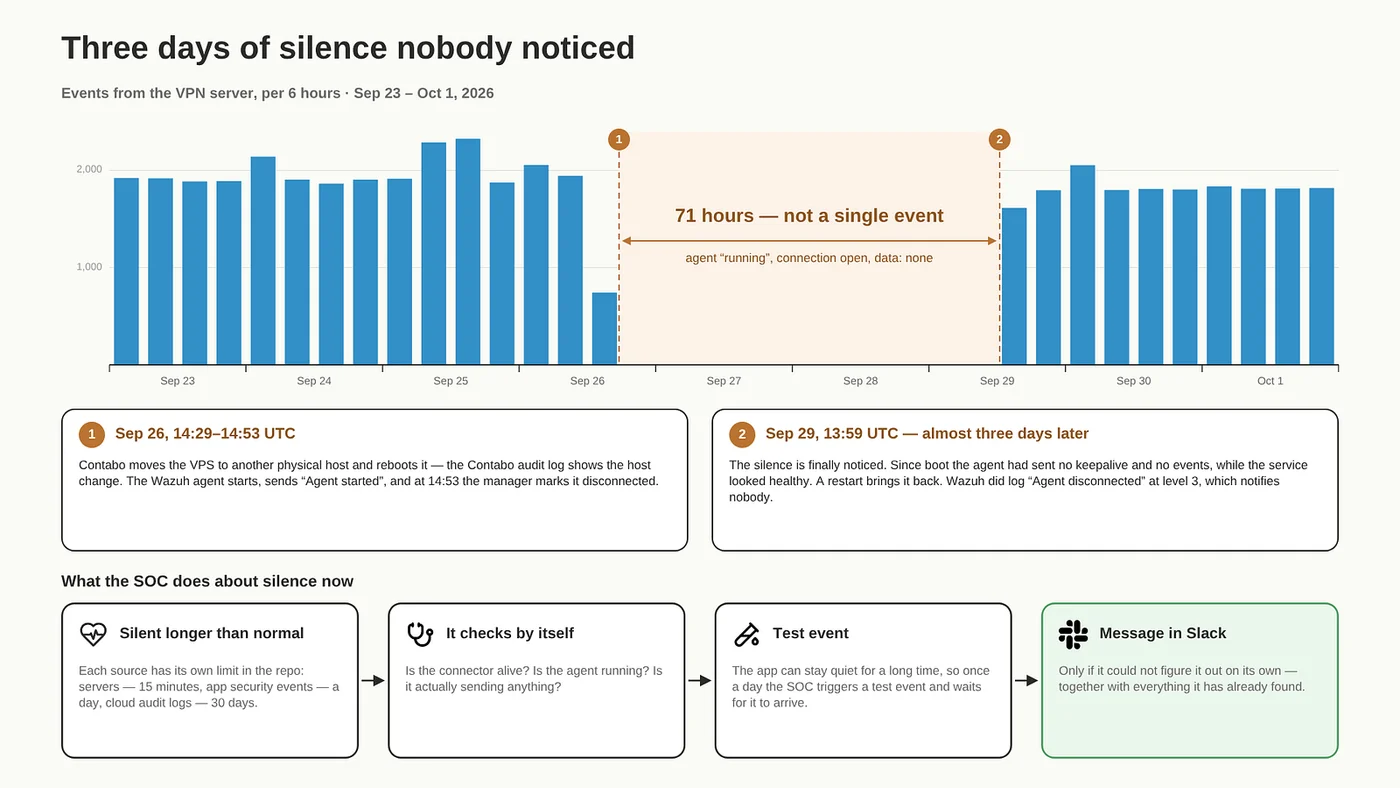
После этого я сделал отдельный сервис, который мониторит состояние источников. Для каждого источника в репозитории записано, сколько ему нормально молчать: серверы и приложение шлют события постоянно, а к примеру журнал аудита облака может молчать несколько дней. Если источник молчит дольше нормы, сервис сначала проверяет его сам: жив ли коннектор, работает ли агент на сервере и отправляет ли он что-нибудь. Для приложения, которое может подолгу молчать, он раз в сутки сам вызывает тестовое событие и проверяет, что оно дошло до SOC. И только если сервис разобраться сам не смог, пишет мне в Slack — сразу с тем, что уже выяснил.
ЧТО SOC УЖЕ НАШЁЛ
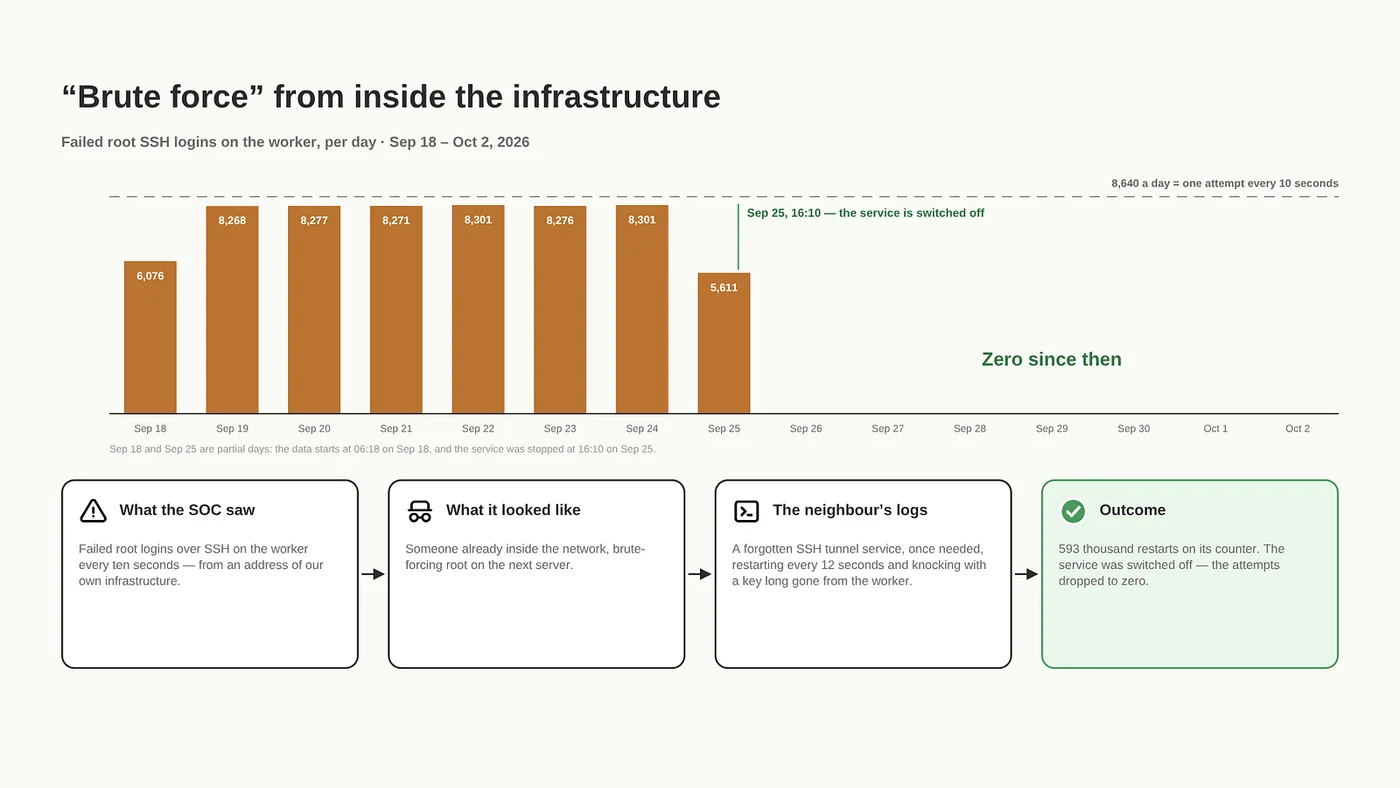
Первое, что SOC обнаружил, — это сотни оборванных попыток войти по SSH под root, каждые десять секунд, с адреса нашей же инфраструктуры. Выглядело как чей-то перебор изнутри. Разгадка нашлась в логах соседнего сервера: забытый старый сервис — SSH-туннель, который когда-то был нужен, — перезапускался каждые 12 секунд и ломился на воркер с ключом, которого там давно нет. Счётчик его перезапусков дошёл до 593 тысяч. Сервис отключили — спасибо, SOC!
Также после получения первых данных по API из GitHub выяснилось, что ключ продуктивного сервера к репозиторию по ошибке имел доступ на запись. То есть компрометация продуктивного сервера позволяла бы ещё и менять код в репозитории. Это тоже исправили.
Кроме этого, было обнаружено ещё много мелочей, но о них я расскажу позже.
И SOC действительно живёт на одном сервере. Сейчас он получает в среднем 55–75 тысяч событий в сутки. И это с учётом того, что часть бесполезных событий мы отфильтровали на Vector (около 100 тысяч событий в сутки). Весь SOC занимает около 2,4 ГБ оперативной памяти: 1,5 ГБ — ClickHouse, 0,5 ГБ — Wazuh, остальное — коннекторы и сервисы по несколько десятков мегабайт. Сутки логов занимают на диске около 8 МБ: ClickHouse сжимает их почти в 8 раз, в среднем около 110 байт на событие, так что год логов при нынешнем потоке уложится примерно в 3 ГБ.
ЧТО ДАЛЬШЕ
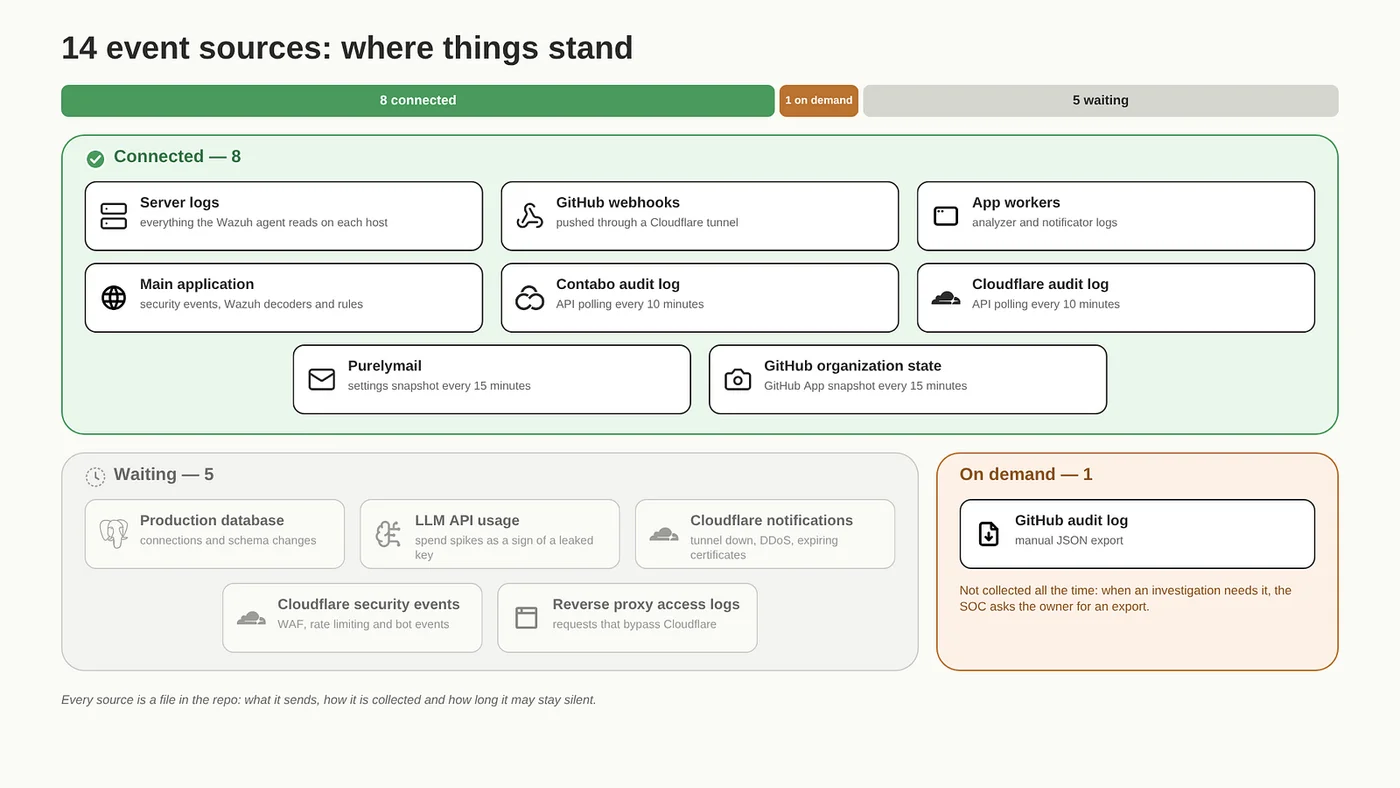
Сейчас SOC видит серверы, основное приложение и основные облачные сервисы, сам следит за тем, чтобы ничего не отвалилось, и уже в первые дни показал то, чего я не замечал. При этом ещё шесть источников ждут подключения — база данных, сервис LLM, вебхуки Cloudflare и другие.
Таким образом, SOC для маленького проекта уже возможен, и это не команда из десяти человек и не дорогая подписка. Это один сервер, набор open-source продуктов и немного затрат на ИИ-токены.
В следующих статьях расскажу о том, как коррелятор превращает алерты в инциденты, о своих экспериментах с ИИ-агентами, которые ведут расследования и пытаются реагировать на инциденты самостоятельно, а также о том, во сколько всё это обходится.
Подписаться на новые статьи
Одно письмо, когда выходит новая статья. Больше ничего.